T.R.A.C.K. — Zeiterfassung, die nichts verrät
Vorgeschichte: wo ist der Tag hin?
Wer remote und asynchron arbeitet, kennt die Frage am Abend: Was habe ich heute eigentlich gemacht? Und vor allem: wie lange? Die klassische Antwort ist ein Timer, den man startet und stoppt. Nur vergisst man genau das ständig. Man startet ihn zu spät, lässt ihn über die Mittagspause laufen, und das spontane Meeting am Whiteboard landet nirgends. Am Ende des Monats rekonstruiert man dann Stundenzettel aus dem Gedächtnis und dem Browserverlauf. Macht keinen Spaß.
Die bequemen Alternativen sind fast alle SaaS: Man installiert einen Agenten, der jedes Fenster, jeden Tab und bei manchen Tools sogar Screenshots in irgendeine Cloud schiebt. Für mich ein klares Nein. Was ich am Rechner tue, geht niemanden etwas an, und schon gar nicht einen Dienst, dessen Server ich nie gesehen habe.
Auf der anderen Seite gibt es ActivityWatch: Open Source, läuft lokal, protokolliert brav jedes Fenster. Großartig, aber es kennt nur den Rechner, auf dem es läuft. Die Bahnfahrt zum Kunden, das Audit vor Ort oder das Brainstorming ohne Tastatur tauchen dort nicht auf, und aus Laptop und PC wird kein gemeinsamer Arbeitstag.
Also habe ich mir das gebaut, was ich eigentlich haben wollte: T.R.A.C.K., kurz für Time Recording via ActivityWatch, Custom hardware & Key-value. Passive Erfassung am Rechner, dazu ein expliziter Kontext („jetzt Meeting“, „jetzt Reise“) per Waybar, Kommandozeile, Handy und demnächst per Würfel auf dem Schreibtisch. Das Ganze läuft auf meinem eigenen NixOS-Server, und die Rohdaten verlassen meinen Rechner nie.
Angefangen hat es am 22. Oktober mit einem Haufen Notizen. Seit dem 2. November läuft der Server produktiv, einen Tag später kam die Waybar dazu, und seit heute sind auch die passive Erfassung und die Handy-App abgenommen. Dieser Beitrag erklärt, wie das Ding aufgebaut ist, warum es so aufgebaut ist und wo ich unterwegs überall gestolpert bin. Am Ende gibt es einen Ausblick auf den Würfel, denn der fehlt noch.
die Idee in drei Sätzen (die Architektur)
- Passiv: ActivityWatch läuft lokal auf jedem Desktop. Ein kleiner Daemon namens
trackdordnet die Aktivität über Regeln Projekten zu und lädt pro 5-Minuten-Slot nur die aktiven Sekunden und das Projekt hoch. - Aktiv: Waybar, CLI, Handy und später der Würfel legen fest, was gerade läuft und wie gearbeitet wird.
- Backend: PocketBase auf
fxb-srv-n1x-01, demselben NixOS-Server, auf dem auch dieser Blog läuft. Davor sitzt Traefik, und die ganze Domain ist nur mit Client-Zertifikat erreichbar.
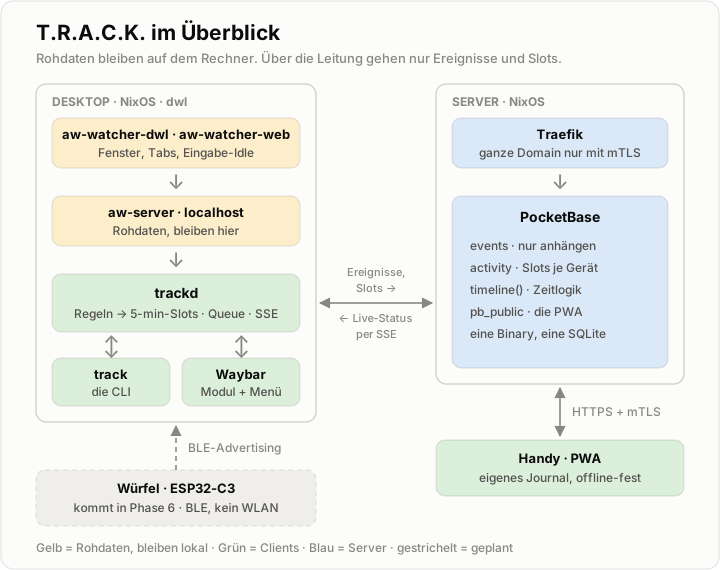
Gelb bleibt auf dem Rechner. Über die Leitung gehen nur Ereignisse und Slots.
Warum PocketBase? Weil es eine einzige Binary ist, die SQLite, Authentifizierung, REST, Realtime per Server-Sent Events und JavaScript-Hooks mitbringt. Für eine Person mit ein paar Geräten ist das mehr als genug, und das Backup ist ein konsistenter SQLite-Dump, den das vorhandene restic-Setup mitnimmt. Der Client ist Python, weil das ActivityWatch-Ökosystem größtenteils Python spricht und bleak später das Bluetooth für den Würfel übernimmt. Alle Abhängigkeiten kommen aus nixpkgs. Kein pip install, kein npm, keine zweite Versionsquelle neben dem flake.lock.
Ein paar Grundsätze haben sich durch das ganze Projekt gezogen, und an ihnen hängt fast jede Entscheidung, die weiter unten auftaucht:
- Rohdaten bleiben lokal. Fenstertitel, URLs und Pfade sieht der Server nie.
- Fakten speichern, Zeiten berechnen. Dazu gleich mehr, das ist das Herzstück.
- Explizit schlägt automatisch. Was ich per Klick sage, gilt. Die Aktivität füllt nur die Lücken.
- Offline-fest und idempotent. Jedes Ereignis bekommt seine ID und seinen Zeitpunkt schon beim Anlegen. Ein zweiter Upload erzeugt kein Duplikat.
- Alles in UTC. Der Server kennt keine Zeitzonen, Tagesgrenzen rechnen die Clients.
- Schema als Code. Collections entstehen nur über Migrations im Repo, nie per Klick im Admin-UI.
das Herzstück: Fakten speichern, Zeiten berechnen
Der erste Entwurf sah aus wie jede Zeiterfassung: eine Tabelle mit Zeiteinträgen (Start, Ende, Projekt) und ein globaler Zustand „was läuft gerade“. Das hält genau so lange, bis die erste Frage auftaucht. Was passiert, wenn der Laptop offline umschaltet und das Handy gleichzeitig online? Wenn ein Würfel-Ereignis erst zehn Minuten später über ein Gateway eintrifft? Wer stellt sicher, dass es nie zwei laufende Einträge gibt, dass das Ende nach dem Start liegt, dass sich Auto-Zeiten nicht mit expliziten überschneiden? Jede dieser Invarianten wäre ein Hook gewesen, der beim Schreiben aufpassen muss. Und jeder dieser Hooks eine Stelle, an der es schiefgehen kann.
Also habe ich den Spieß umgedreht. Der Server speichert nur noch Fakten:
events: „Ab Zeitpunktatgilt Modus X mit Projekt Y.“ Ein Ereignis gilt, bis das nächste kommt.activity: pro Gerät und 5-Minuten-Slot die aktiven Sekunden und das Projekt, das die Regeln dafür ermittelt haben.
Die eigentliche Zeitleiste rechnet eine einzige reine Funktion beim Lesen aus: timeline(events, activity, from, to, now) in pb_hooks/lib/timeline.js. Kein Datenbankzugriff, keine eigene Uhr, die aktuelle Zeit kommt als Parameter. Es ist die einzige Stelle im ganzen System mit Zeitlogik. Wenn das ein bisschen nach Event Sourcing klingt: ja, genau.
Die angenehmen Folgen kamen fast von allein:
- Verspätete Ereignisse werden nach
ateinsortiert, und die Zeitleiste stimmt danach automatisch. - Es gibt strukturell nur einen laufenden Modus. Die ganzen Invarianten entfallen, weil sie gar nicht mehr verletzt werden können.
- Korrekturen sind normale Ereignisse. Wer um 9 Uhr vergessen hat zu starten, trägt
track start kundenportal --at 9:00nach. - Bei ein paar Dutzend Ereignissen am Tag kostet die Berechnung beim Lesen nichts.
Projekt und Modus sind zwei Achsen
Das Projekt sagt, woran ich arbeite. Der Modus (kind) sagt, wie. Dasselbe Projekt kommt am Rechner vor (work) und im Meeting (meeting), und das macht für die Zeiterfassung einen großen Unterschied:
| Modus | Projekt | zählt | AFK-Regel | Sicherheitsnetz |
|---|---|---|---|---|
work, focus | Pflicht | ja | ja | – |
meeting | Pflicht | ja | nein | 3 h |
audit | Pflicht | ja | nein | 10 h |
travel | optional | ja, getrennt ausgewiesen | nein | 12 h |
auto | – | über Aktivität und Regeln | – | – |
pause, off, vacation, sick | – | nein | – | – |
Bei meeting, audit und travel arbeite ich fern der Tastatur, deshalb greift dort die AFK-Regel nicht. Damit ein vergessenes Meeting nicht bis Weihnachten weiterzählt, gibt es ein Sicherheitsnetz: Nach drei Stunden Meeting gilt die AFK-Regel wieder. Und pause ist bewusst etwas anderes als auto. In der Mittagspause zählt auch das Surfen am Rechner nicht. Im Modus auto arbeite ich und lasse die Regeln zuordnen.
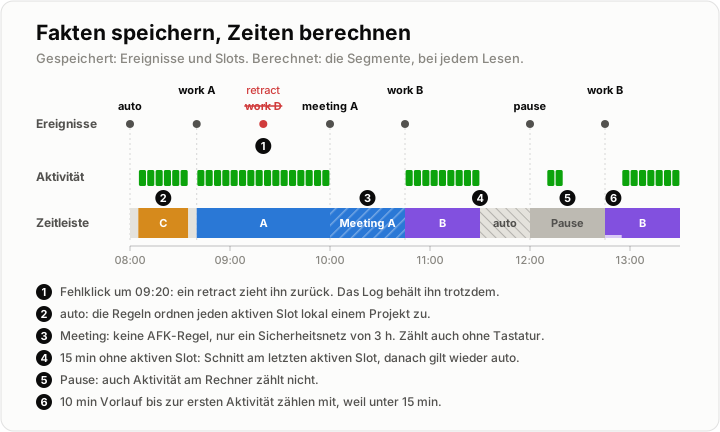
Gespeichert sind nur die oberen beiden Zeilen. Die untere entsteht bei jedem Lesen neu.
Damit die Clients die Tabelle nicht nachbauen müssen, trägt jedes Segment eine Kategorie: work, travel, unassigned oder none. CLI, Waybar und Handy summieren nur danach. „Nicht zugeordnet“ zählt dabei bewusst nicht als Arbeit, steht aber im Report, damit ich die Regeln nachschärfen kann. Und damit davon im Alltag nicht zu viel übrig bleibt, gibt es ein Auffangprojekt: eine ganz normale Regel mit dem Muster .* und der niedrigsten Priorität. Kein Sonderfall im Code, nur eine Regel.
Nichts wird gelöscht
Das Ereignis-Log ist strikt append-only. Ein Fehlklick wird nicht gelöscht, sondern per retract zurückgezogen: ein neues Ereignis, das auf die external_id des alten zeigt. Die Routen filtern zurückgezogene Ereignisse heraus, bevor timeline() rechnet, die Historie bleibt aber vollständig. Ein Hook verbietet Update und Delete auf events sogar für den Superuser im Admin-UI.
💡 Kleines Detail mit großer Wirkung:
track undozieht das zuletzt angelegte eigene Ereignis zurück, nicht das letzte nachat. Sonst träfe es nach dem Eintragen eines Urlaubs das geplanteoffam Urlaubsende, das ja zeitlich hinten liegt.
die Feinheiten der Zeitleiste (AFK, Vorlauf, Sicherheitsnetz)
Klingt bis hier alles schön einfach. Der Teufel steckt, wie immer, in der Zeit.
AFK: Ein Segment mit AFK-Regel endet, wenn 15 Minuten lang auf keinem Gerät ein aktiver Slot war. Das Ende liegt dann beim letzten aktiven Slot, danach gilt auto. Es geht also nicht automatisch mit dem Projekt weiter, aber die Arbeit nach der Rückkehr wird über die Regeln erfasst. Laufen Laptop und PC gleichzeitig, gewinnt pro Slot das Gerät mit den meisten aktiven Sekunden. So wird nie doppelt gezählt.
Vorlauf: Was ist mit track start X --at 9:00, wenn die erste Aktivität erst um 9:20 kommt? Eine strikte AFK-Uhr ab Segmentbeginn hätte die Korrektur sofort wieder abgeschnitten. Die Lösung: Bis zur ersten Aktivität läuft die Uhr nicht. Unter 15 Minuten zählt der Vorlauf mit, wie jede kurze Lücke. Ab 15 Minuten zählt er nicht, das Segment bleibt aber stehen und zählt ab der ersten Aktivität. Kommt eine ganze Stunde lang nichts, gilt das Ereignis als verwaist.
Der rechte Rand: trackd lädt Slots nur einmal pro Minute hoch. Liefe die AFK-Uhr bis now, würde der Status ständig zwischen „aktiv“ und „AFK“ flackern. Deshalb läuft sie nur bis now − 2 min. Und alles nach now ist Plan: Ereignisse in der Zukunft (etwa das off am Ende eines eingetragenen Urlaubs) erscheinen als geplante Segmente, ohne AFK-Regel. Sonst hätte die Abfrage „heute bis Mitternacht“ das laufende Segment per AFK abgeschnitten, weil die Zukunft naturgemäß keine Aktivität hat.
Mein Lieblingsmoment im ganzen Projekt war ein Eigenschaftstest: Für beliebige Zeitpunkte muss gelten timeline(a, b) = timeline(a, m) + timeline(m, b). Der Tagesreport muss exakt ein Ausschnitt des Wochenreports sein. Dieser Test hat zwei echte Designfehler gefunden, bevor eine einzige echte Minute erfasst war:
- Ob ein Segment kurz vor dem Ende des Abfragefensters per AFK endet, entscheidet erst die Aktivität danach. Gerechnet wird deshalb über
[from − 24 h, to + 60 min)und erst am Ende zugeschnitten. - Die Markierung „hier wurde per AFK geschnitten“ hing zuerst am geschnittenen Segment. Ein Tagesausschnitt konnte sie dann nicht kennen, wenn der Schnitt erst am nächsten Tag passierte. Jetzt hängt sie an der Zeit nach dem Schnitt.
Getestet wird die Zeitleiste über Golden Cases: JSON-Dateien mit Ereignissen, Aktivität, now und den erwarteten Segmenten. Dieselben Fälle laufen einmal per node --test direkt gegen timeline.js und einmal per pytest über HTTP gegen eine echte PocketBase. Die führt nämlich dieselbe Datei in ihrer eingebauten JavaScript-Engine aus.
Rohdaten bleiben lokal (die passive Erfassung)
Meine Desktops laufen mit dwl unter Wayland, und genau da liegt der erste Stolperstein: Die Standard-Watcher von ActivityWatch für Fenster und AFK funktionieren nur unter X11. Also gibt es einen eigenen, schlanken Watcher, aw-watcher-dwl. Das fokussierte Fenster liefert das IPC-Protokoll aus dem ipc-Patch von dwl (Titel und App-ID), die Abwesenheit kommt über ext-idle-notify-v1. Er schreibt Heartbeats in dieselben Buckets wie die Standard-Watcher, sodass das Web-UI von ActivityWatch sie ganz normal anzeigt.
Auf dem Weg dahin gab es zwei Überraschungen:
- Idle-Inhibitoren: Das Protokoll gibt es in zwei Varianten. Die eine respektiert Programme, die den Bildschirmschoner unterdrücken, die andere misst nur die Eingabe. Ich nehme die zweite. Ein Video ohne Tastatur und Maus zählt also als AFK, was für eine Zeiterfassung genau richtig ist.
- Heartbeats, die sich gegenseitig fressen:
aw-server-rustersetzt bei einem Heartbeat alle Ereignisse, deren Ende auf das späteste Ende im Bucket fällt. Ein schließender Heartbeat für das alte Fenster und ein neues Ereignis im selben Augenblick überschreiben sich dann gegenseitig. Die Lösung ist herrlich banal: Neue Ereignisse beginnen eine Millisekunde nach dem Ende des vorigen, genau wie beim offiziellen AFK-Watcher.
Für Browser kommen URL und Tab-Titel von aw-watcher-web. Das musste ich übrigens von Hand aus dem Add-on-Katalog installieren, die Policy im Browser wollte es partout nicht ausrollen. Warum, ist bis heute offen.
trackd liest die Rohdaten jede Minute aus dem lokalen aw-server und klassifiziert sie mit einer reinen Funktion: Fenster mit „nicht AFK“ verschneiden, bei Browsern URL und Tab einmischen, dann die Regeln anwenden. Eine Regel ist ein regulärer Ausdruck auf App, Titel oder URL mit einer Priorität:
track rules add kundenportal title 'code/kundenportal' --priority 5
track rules add kundenportal url 'portal\.example\.com' --priority 3
track rules add kleinkram app '.*' --priority -1000     # die Auffangregel
Das Projekt eines Slots ist die Mehrheit der aktiven Sekunden, und „nicht zugeordnet“ ist dabei ein eigener Kandidat. Drei Minuten Chat und zwei Minuten Projektarbeit ergeben also keine Projektzeit.
⚠️ Der Server kennt keine Rohdaten. Das ist der Sinn der Sache, hat aber eine Folge: Ändere ich eine Regel, kann der Server die Vergangenheit nicht neu zuordnen. Das muss
trackdtun. Er merkt sich einen Hash über die Regeln, ordnet bei jeder Änderung die letzten sieben Tage aus den lokalen Rohdaten neu zu und lädt nur die Slots hoch, die sich dadurch ändern. Sonst bliebe „nicht zugeordnet“ für immer „nicht zugeordnet“.
Eine Regel auf code/kundenportal greift natürlich nur, wenn der Pfad auch im Fenstertitel steht. Das war die letzte Baustelle vor der Abnahme. Fish setzt den Titel jetzt per fish_title auf Befehl und vollen Pfad, VS Code bekommt window.title mit ${rootPath}. Und Claude Code schreibt den Terminaltitel gern selbst um, bis man ihm per CLAUDE_CODE_DISABLE_TERMINAL_TITLE=1 den Mund verbietet. Alle drei Änderungen kommen per Home Manager auf jeden Rechner.
Welche Fenster gerade nur die Auffangregel trifft, zeigt track activity lokal an, und track rules test ist ein Trockenlauf auf den eigenen Daten. Beides geht nur über den Socket von trackd, nie über den Server.
trackd, CLI und Waybar (der Alltag am Desktop)
trackd ist der lokale Knoten auf jedem Desktop. Nur er kennt Passwort und Client-Zertifikat. Die CLI track und die Waybar sprechen ausschließlich über einen Unix-Socket mit ihm ($XDG_RUNTIME_DIR/track.sock, NDJSON, Rechte 0600). Dadurch startet die CLI schnell, Umschalten funktioniert auch offline, und die Waybar aktualisiert sich sofort, ohne Polling.
Im Alltag fasse ich die CLI aber kaum an. Fast alles passiert über das Waybar-Modul: Es zeigt Modus, Projekt in Projektfarbe und die Laufzeit. Ein Linksklick öffnet ein Menü in fuzzel, ein Rechtsklick wechselt zwischen Pause und „weiter“, ein Mittelklick schaltet das Meeting auf dem laufenden Projekt an und aus.
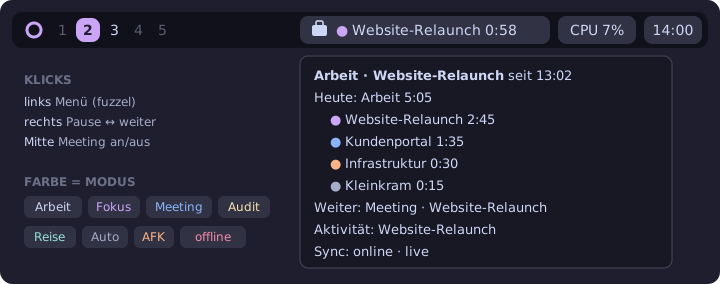
Das Modul in der Waybar (Mockup mit erfundenen Projekten). Die Farbe des Moduls zeigt den Modus.
Das Menü nach einem Linksklick sieht so aus. Oben steht das Rücksprungziel, darunter die zuletzt genutzten Projekte und die Modi:
↺ weiter: Meeting · Website-Relaunch
● Website-Relaunch  (läuft)
● Kundenportal
● Infrastruktur
● Kleinkram
● Vereinsarbeit
Fokus · Website-Relaunch
Meeting · Website-Relaunch
Audit · Website-Relaunch
Reise
Auto
Pause
Feierabend
Und so sieht die Kommandozeile aus, wenn man sie doch mal braucht:
$ track start kundenportal --at 8:55
✓ Arbeit · ● Kundenportal ab 08:55 (gespeichert)
$ track meeting relaunch
✓ Meeting · ● Website-Relaunch ab 10:30 (gespeichert)
$ track report --day
Mi 04.11.2026  Arbeit 5:05
  Website-Relaunch    2:45
  Kundenportal        1:35
  Infrastruktur       0:30
  Kleinkram           0:15
Das Rücksprungziel „weiter“ klingt trivial, war es aber nicht. Es ist der letzte zählende explizite Modus mit Projekt, der sich vom aktuellen unterscheidet. Nach dem Meeting geht es zurück zur Arbeit am selben Projekt, nach der Pause zum letzten Projekt. Und genau hier lauerte der fieseste Fehler der Desktop-Phase.
Stolpersteine
Der veraltete Status. Anzeige und Rücksprungziel kamen zuerst aus dem letzten Status vom Server. Ein Rechtsklick in die Pause und direkt ein zweiter zurück konnte dann zum Ziel vor dem laufenden Projekt springen, weil der neue Status noch nicht da war. Offline zurückgezogene Ereignisse blieben sichtbar, und ein langsamer älterer Refresh konnte einen neueren überschreiben. Die Lösung ist eine lokale Sicht: trackd merkt sich, welche eigenen Ereignisse der Serverstatus noch nicht enthalten kann, rechnet Anzeige und Rücksprungziel daraus und verwirft Antworten, deren Anfrage älter ist als die des gültigen Status. Gezählt wird trotzdem nur in timeline(), die lokale Sicht ist reine Anzeige.
SSE ohne Keepalive. Für Realtime gibt es kein Python-SDK von PocketBase, also baut trackd das Protokoll selbst nach: GET /api/realtime liefert eine Client-ID, ein POST mit Token setzt das Abo. Danach kam die Überraschung: PocketBase schließt eine ruhige Verbindung nach 301 Sekunden und schickt vorher keine Keepalives. Traefik kappt SSE ohnehin nach spätestens zehn Minuten. trackd verbindet sich deshalb sofort neu und holt den Status nach, damit aus der Lücke nichts fehlt. Ein Lese-Timeout von 330 Sekunden erkennt tote Verbindungen nach Suspend oder WLAN-Wechsel.
Erfolg, der keiner ist. Ein Captive Portal im Zug antwortet gern mit 200 und einer HTML-Seite. Eine 2xx-Antwort ohne JSON gilt deshalb als „offline“ und nicht als „gespeichert“.
PocketBase antwortet kreativ. Ein verbotenes Anlegen eines Projekts beantwortet PocketBase mit einem nackten 400, ein verbotenes Ändern mit 404. Daraus eine sinnvolle Fehlermeldung zu bauen, ist schwierig. Deshalb prüft trackd die Rechte vorher selbst.
Das Rate-Limit gilt pro IP. Erlaubt sind zwei Logins in drei Sekunden. Starten zwei Desktops hinter demselben Router gleichzeitig, bekommt einer 429. Also gibt es einen Backoff, der Retry-After respektiert.
offline-fest (die Queue)
Jedes Umschalten landet zuerst im lokalen Journal (SQLite bei trackd, IndexedDB beim Handy) und geht erst danach ins Netz. Die external_id (eine UUID) und der Zeitpunkt at entstehen beim Tippen, nicht beim Senden. Kommt das Ereignis nach einer Stunde Funkloch an, trägt es trotzdem seinen echten Zeitpunkt. Und wird es doppelt gesendet, antwortet der Server einfach mit dem schon vorhandenen Ereignis.
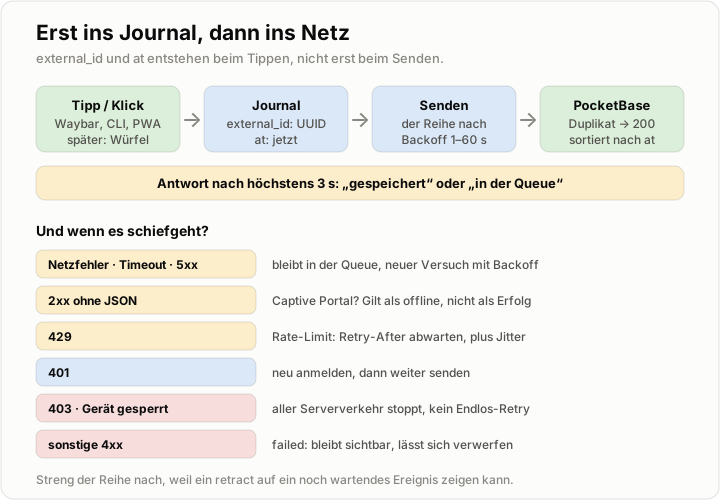
Erst ins Journal, dann ins Netz, und für jede Antwort eine klare Reaktion.
Gesendet wird streng in Anlegereihenfolge. Das klingt pedantisch, ist aber nötig: Ein retract kann auf ein Ereignis zeigen, das selbst noch in der Queue wartet. Käme es vorher an, würde der Server es ablehnen.
Ein Umschalten wartet bis zu drei Sekunden auf den Server und meldet dann „gespeichert“ oder „in der Queue“. Lehnt der Server in dieser Zeit ab, wird der Eintrag verworfen. Der Fehler steht ja direkt vor mir. Lehnt er erst später ab, etwa nach einer Offline-Phase, wird der Eintrag failed und bleibt sichtbar, bis ich ihn verwerfe. Ein gesperrtes Gerät (403) stoppt allen Serververkehr, statt sich endlos die Zähne auszubeißen.
Die Slots laufen getrennt von den Ereignissen: neueste zuerst, damit der laufende Slot nicht hinter einem Rückstau wartet, in Batches bis 500. Ein Fallstrick dabei: Der Server lehnt einen ganzen Batch ab, sobald ein einziger Slot ungültig ist, etwa weil sein Projekt inzwischen gelöscht wurde. Dann sendet trackd die Slots einzeln, und nur der ungültige wird failed.
Server und Deployment (NixOS bis zum Schluss)
Der Server ist ein NixOS-Modul aus dem Flake des Projekts, nixosModules.track-server. Es bleibt bewusst generisch. Traefik-Router, Backup, Secrets und DNS verdrahtet ein schmales Glue-Modul in meinem NixOS-Monorepo. Ein paar Dinge, die ich dabei gelernt habe:
- PocketBase kommt aus dem eigenen Lock. Der stabile NixOS-Kanal bringt PocketBase 0.38 mit, entwickelt habe ich gegen 0.39.11, und die JavaScript-API ändert sich zwischen Minor-Versionen. Deshalb folgt das Flake-Input hier ausnahmsweise nicht dem nixpkgs des Hosts. Sonst würde ein ganz normales System-Update ungetestet eine andere PocketBase einspielen.
--automigrate=false, weil PocketBase sonst bei Schemaänderungen Migrationsdateien schreiben will, mitten in den read-only Nix-Store.DynamicUserund Secrets vertragen sich nicht: Der dynamische Nutzer kann die root-eigenen sops-Dateien nicht lesen. Die Passwörter kommen deshalb perLoadCredentialin die Unit.- Geräte sind deklarativ. Ein Konsolenbefehl
provisionlegt beim Start Superuser und Geräte aus einer Nix-Spec an. Ein Passwort setzt er nur, wenn es abweicht, denn sonst würde jeder Neustart alle Tokens ungültig machen. Geräte, die nicht mehr in Nix stehen, werden gesperrt, nie gelöscht. Ihre Ereignisse bleiben. - Die ganze Domain liegt hinter mTLS. Traefik wählt die TLS-Optionen pro Hostname, mTLS für einzelne Pfade bräuchte also eine zweite Domain. So ist das Admin-UI ohne Zusatzaufwand geschützt, und die Geräte-Logins sind eine zweite Schicht, nicht die einzige.
Stolpersteine
Exit-Code 0 bei fatalen Fehlern. PocketBase beendet sich bei einem belegten Port mit Code 0, und bei Fehlern in Konsolenbefehlen ebenfalls. Restart=on-failure greift damit nie. Die Unit läuft deshalb mit Restart=always und Start-Limit, und provision beendet sich bei Fehlern selbst mit 1, damit ExecStartPre die Unit wirklich stoppt.
Löschen schreibt die Geschichte um. Beim Blick in den Go-Code von PocketBase fiel auf: Löscht man ein Projekt, leert PocketBase die optionale Relation events.project stillschweigend. Aus „zwei Stunden Kundenportal“ würde nachträglich „zwei Stunden ohne Projekt“. Projekte, auf die etwas verweist, lassen sich deshalb nicht löschen, nur archivieren.
Testen in der Produktion, ohne Spuren. Wenn das Log append-only ist, wie testet man nach einem Rollout? Der Smoke-Test legt seine Ereignisse in der Vergangenheit an, an einem Tag im Januar, und zieht sie danach per retract zurück. Das Log enthält sie, die Zeitleiste ist wieder leer.
Ein grep hat einen roten Test grün gefärbt. Vor jedem Merge läuft nix flake check mit der Node- und pytest-Suite und einem echten NixOS-VM-Test. Einmal hing hinten ein | grep dran, und der Exit-Code des fehlgeschlagenen Testlaufs verschwand in der Pipe. Seitdem gilt: Exit-Code prüfen, nie maskieren. main ist das, was der Server beim nächsten Update bekommt, und muss deshalb immer deploybar sein.
das Handy (die PWA)
Unterwegs ist das Handy der natürliche Ort für travel und audit. Statt einer nativen App gibt es eine PWA, die PocketBase gleich mit ausliefert: Vanilla-ES-Module, kein Build-Schritt, kein npm. Die reine Logik (Summen, Tagesgrenzen, Rücksprungziel, Fehlerklassen, Queue) steckt in eigenen Modulen und ist per node --test geprüft. Die Oberfläche ist nur eine dünne Schicht darüber. Ein End-to-End-Test mit Playwright und Chromium aus nixpkgs loggt sich ein, schaltet um, geht offline, lädt neu und prüft, dass die Queue danach in der richtigen Reihenfolge ankommt.
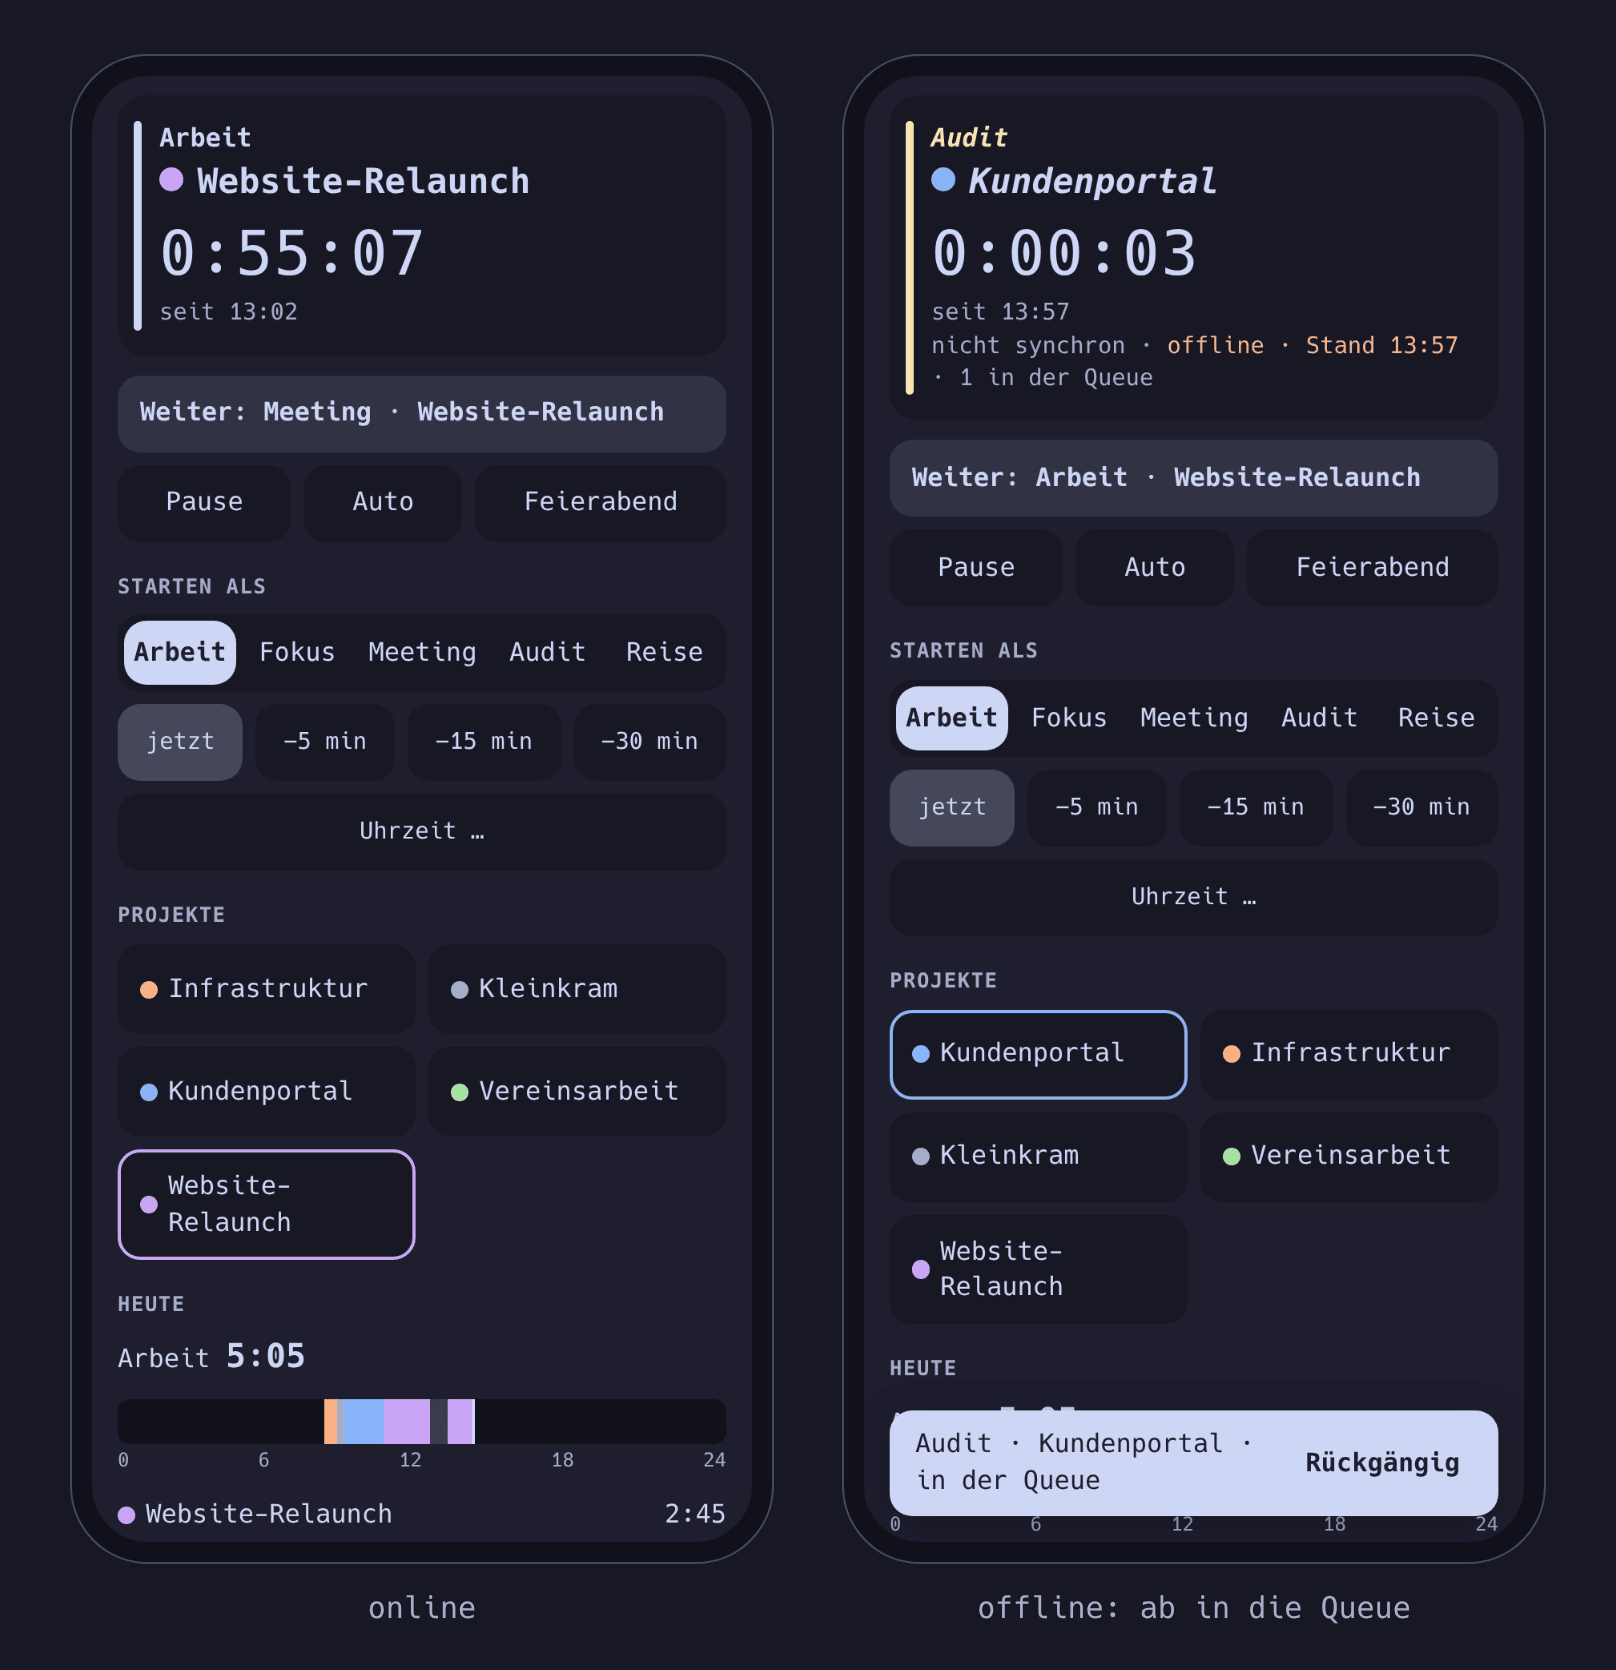
Links online, rechts im Flugmodus: Das Umschalten landet in der Queue und geht raus, sobald wieder Netz da ist. (Echte Screenshots, erfundene Projekte.)
Was sie kann:
- Status mit Timer, „Weiter“, Pause, Auto und Feierabend
- eine Modusleiste (Arbeit, Fokus, Meeting, Audit, Reise) für den nächsten Tipp auf ein Projekt
- Nachtragen: „vor 5/15/30 Minuten“ oder zu einer Uhrzeit, heute oder gestern
- Rückgängig nach jedem Umschalten, dazu „Letztes zurückziehen“
- die Tagesleiste von Mitternacht bis jetzt in Projektfarben, dazu die Tagessumme
- Kurzbefehle am App-Icon, die sich auch einzeln auf den Homescreen legen lassen
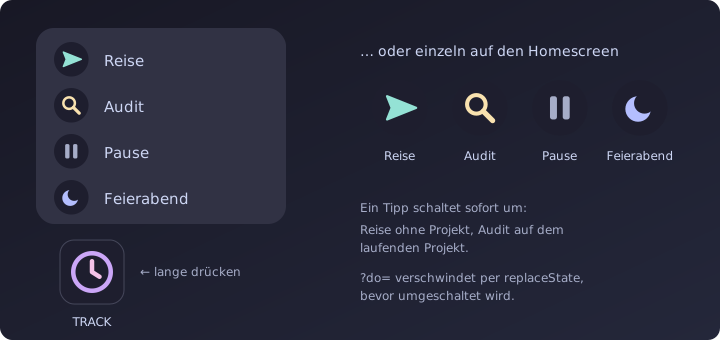
Die vier Kurzbefehle am App-Icon. Mein Launcher bietet sie sogar als Widget an.
Angemeldet ist die PWA als eigenes Gerät. Das Passwort bleibt auf meinen Wunsch im Handy gespeichert, damit sie sich nach Ablauf des Tokens (bei PocketBase sieben Tage) selbst neu anmeldet. Abgetippt habe ich es nie, es kam einmalig per QR-Code vom Desktop, direkt aus sops:
sops -d --extract '["track_device_phone"]' secrets/server.yaml | qrencode -t ansiutf8
Ein verlorenes Handy wird gesperrt wie jedes andere Gerät. Und ohne das Client-Zertifikat kommt ohnehin niemand bis zum Login.
Stolpersteine
Die PWA hatte die schönsten Fallen von allen.
Die mtime-Falle. Nix setzt den Zeitstempel jeder Datei im Store auf 1, also auf eine Sekunde nach Beginn der Unix-Zeit. Der Go-Dateiserver in PocketBase antwortet deshalb mit Last-Modified: 1970 und beantwortet jedes If-Modified-Since mit 304 Not Modified, auch nach einem Deploy mit neuer Datei. Das Handy hätte nie wieder eine neue Version gesehen.
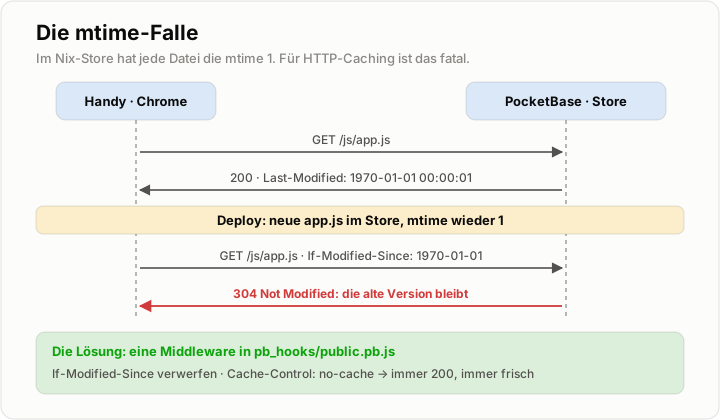
Reproduzierbare Builds sind toll, bis HTTP nach dem Datum fragt.
Die Lösung ist eine kleine Middleware in pb_hooks/public.pb.js. Sie wirft für alle Pfade außer API und Admin-UI das If-Modified-Since aus der Anfrage, setzt Cache-Control: no-cache und bei der Gelegenheit gleich eine strenge Content-Security-Policy. Der Service Worker lädt die App-Shell network-first und braucht dadurch nicht einmal eine Versionsnummer.
mTLS und das Manifest. Chrome legt das Client-Zertifikat nur Anfragen mit Credentials bei. Das Web-App-Manifest wird aber standardmäßig ohne geladen, prallt an Traefik ab, und ohne Manifest gibt es keine Installation. Ein crossorigin="use-credentials" am <link rel="manifest"> löst das. Danach lief alles hinter mTLS: Installation als echte App, Kurzbefehle, Service Worker und Live-Updates.
Vary: Origin bricht den Offline-Start. PocketBase schickt bei jeder Antwort Vary: Origin mit. Module werden mit einem Origin-Header angefragt, die Navigation ohne. Damit passte offline die Antwort im Cache nicht mehr zur Anfrage. Abhilfe schafft ignoreVary beim Nachschlagen im Cache.
Traefiks 502. Während PocketBase nach einem Deploy neu startet, antwortet Traefik mit 502. Für den Service Worker war das zuerst eine gültige Antwort, und die App hätte eine Fehlerseite gezeigt statt der Version aus dem Cache. Jetzt führt auch jede 5xx-Antwort zum Cache.
Die Login-Schleife. Scheiterte der Login, versuchte die Realtime-Verbindung es alle fünf Sekunden neu und verbrannte dabei das gemeinsame Rate-Limit aller Geräte. Jetzt stoppt die PWA bei einem gescheiterten Login allen Serververkehr, und mehrere gleichzeitige 401 teilen sich einen einzigen neuen Login.
Seite und Service Worker teilen eine Queue. Beide wollen sie leeren, die Seite sofort und der Service Worker per Background Sync, auch bei geschlossener App. Die Web Locks API (navigator.locks) sorgt dafür, dass immer nur einer sendet. Und ein Kurzbefehl entfernt seinen ?do=-Parameter per replaceState, bevor er umschaltet. Sonst schaltet ein Neuladen ein zweites Mal um.
„nullnull“. Mein Favorit. Im Menü der App stand plötzlich nullnull. Die Ursache: replaceChildren() rendert ein null nicht als nichts, sondern als den Text „null“. Optionale Elemente, die gerade nicht gebraucht wurden, standen also als Wort im Menü. Seit dem Fix prüft der E2E-Test bei jedem Lauf, dass nirgends „null“ oder „undefined“ auf der Seite steht.
Abgenommen habe ich die PWA heute Vormittag am Pixel 8. Zwei Umschaltungen im Flugmodus kamen an, sobald wieder Netz da war, in der richtigen Reihenfolge und mit ihrem ursprünglichen Zeitpunkt, die Tagessumme stimmte mit track report --day überein, und ein Klick in der Waybar erschien sofort am Handy (und umgekehrt).
wie das gebaut wurde (die Arbeitsweise)
Ein Wort zur Arbeitsweise, weil sie für das Ergebnis mindestens so wichtig war wie die Technik. Gebaut habe ich T.R.A.C.K. zusammen mit Claude Code, in festen Phasen mit eigenem Branch:
| Phase | Inhalt | Stand |
|---|---|---|
| 0 | Fundament, Doku, Entscheidungen | ✅ |
| 1 | Server und Zeitleiste | ✅ |
| 2 | Deployment auf NixOS | ✅ |
| 3 | trackd, CLI und Waybar | ✅ |
| 4 | Passive Erfassung | ✅ |
| 5 | Handy-PWA | ✅ |
| 6 | Würfel | als Nächstes |
Jede Phase beginnt mit einem Plan, bevor eine Zeile Code entsteht, und endet mit einem „Fertig, wenn“, das im echten Betrieb geprüft wird. Jede Designentscheidung landet in einem Decision Log. Inzwischen stehen dort 60 Einträge, und revidierte Entscheidungen werden nicht überschrieben, sondern bekommen den Vermerk „ersetzt durch D-xx“. Vor jedem Merge gibt es ein Code-Review. Die Login-Schleife der PWA und der veraltete Status in der Waybar wurden genau dort gefunden, nicht erst im Alltag. Dazu kommen knapp 400 Tests und ein NixOS-VM-Test, der das fertige Paket so startet wie in der Produktion. Und Änderungen am Server-Monorepo und jeder Rollout passieren nur nach meinem ausdrücklichen OK.
Ausblick: der Würfel (Phase 6)
Und jetzt der Teil, auf den ich mich am meisten freue. Auf dem Schreibtisch soll ein Würfel liegen: Die Seite, die oben liegt, ist das Projekt. Umdrehen statt Klicken.
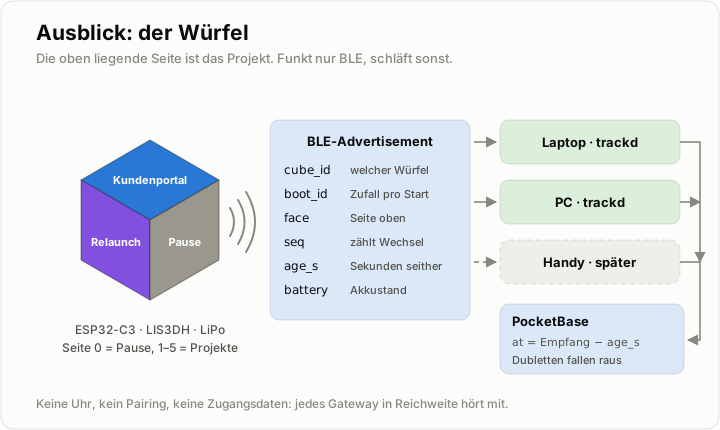
Der Plan für Phase 6: ein Würfel, der nur funkt, wenn er gedreht wird.
Drinnen stecken ein ESP32-C3, ein Beschleunigungssensor LIS3DH und ein LiPo-Akku, außen ein 3D-gedrucktes Gehäuse. Die Firmware erkennt, welche Seite oben liegt. Bleibt eine Seite fünf Sekunden stabil, zählt sie eine Sequenznummer hoch und sendet ein BLE-Advertisement. Die Entscheidungen dazu stehen schon:
- Kein WLAN, kein Pairing. Der Würfel sendet verbindungslos. Jedes Gateway in Reichweite hört einfach mit:
trackdauf Laptop und PC und später das Handy. Der Würfel braucht dadurch keine Zugangsdaten und kein WLAN-Passwort, und Funken per BLE ist deutlich sparsamer. - Keine Uhr im Würfel. Er sendet mit, wie viele Sekunden der Wechsel her ist (
age_s). Das Gateway rechnetat = Empfangszeit − age_s. Wie stark der interne RC-Oszillator dabei driftet, muss der Prototyp zeigen. Notfalls kommt ein 32-kHz-Quarz dazu. - Dubletten fallen raus. Die
external_idistcube_id:boot_id:seq. Hören Laptop und PC dasselbe Paket, entsteht trotzdem nur ein Ereignis. Dieboot_idist eine Zufallszahl pro Start, die Deep Sleep übersteht, aber keinen Stromverlust. Ohne sie würdeseqnach einem Akkutausch wieder bei 0 beginnen, und neue Wechsel würden still als Duplikate verworfen. - Die Belegung steht auf dem Server. Welche Seite welches Projekt ist, steht in
projects.cube_face, nicht in der Firmware. Umbelegen heißt also nicht neu flashen. Seite 0 ist fest die Pause. - Schlafen, bis er bewegt wird. Nach einem Wechsel sendet der Würfel ein paar Sekunden lang häufig, dann selten, dann geht er in Deep Sleep. Wecken soll ihn der Lage-Interrupt des LIS3DH, der nur bei einem echten Seitenwechsel auslöst.
Ein paar Fragen sind noch offen. Ein Doppeltipp soll die aktuelle Seite neu senden, als Wiedereinstieg nach einem AFK-Schnitt. Damit kein Wechsel verloren geht, während gerade kein Gateway zuhört, könnte das Advertisement die letzten zwei oder drei Wechsel mitschicken. Ein optionaler HMAC im Paket soll gefälschte Würfel abwehren, geprüft am liebsten auf dem Server, damit der Schlüssel nur dort liegt. Und das Handy als Gateway ist knifflig, denn Web Bluetooth kann im Hintergrund nicht scannen. Realistisch wird das eine kleine Android-App oder eine Lösung mit Tasker.
Den Anfang macht ein Prototyp auf dem Breadboard: ESP32-C3, LIS3DH, Seitenerkennung über die serielle Konsole. Dazu mehr, sobald der Würfel das erste Mal ein Projekt umschaltet. Bis dahin zählt die Waybar weiter brav meine Stunden.
hack on - euer fuxX
Mehr Informationen
- PocketBase: Backend in einer Binary, mit SQLite, Auth, Realtime und JS-Hooks
- ActivityWatch und aw-watcher-web: lokale, freie Aktivitätserfassung
- dwl und ext-idle-notify-v1: der Compositor und das Idle-Protokoll hinter
aw-watcher-dwl - Martin Fowler: Event Sourcing, die Idee hinter „Fakten speichern, Zeiten berechnen“
- MDN: Web Locks API, Background Synchronization API und Manifest-Shortcuts
- bleak: BLE in Python, für das Gateway in
trackd(Phase 6) - ESP32-C3 und LIS3DH: das Innenleben des Würfels (Phase 6)
- Catppuccin: die Farben von Waybar, PWA und diesem Blog